Sådan bygger man GDPR-sikre AI-applikationer med privat EU-inferens
Introduktion: AI-adoption møder compliance-virkelighed
Kunstig intelligens er flyttet fra eksperimenter til produktionssystemer. Søgeassistenter, automatiseringsworkflows og beslutningsstøtteværktøjer er nu en del af den daglige drift.
For teams, der opererer i Europa, eller betjener europæiske brugere, bliver én begrænsning uundgåelig: hvor AI-inferens sker betyder lige så meget som hvad modellen kan gøre.
Selv når underliggende data er offentlig, kræver brugerforespørgsler, intentioner og interaktionsmønstre omhyggelig håndtering. Denne guide forklarer, hvordan privat EU-baseret AI-inferens kan bruges til at bygge compliant, praktiske AI-applikationer ved hjælp af retrieval-augmented generation (RAG).
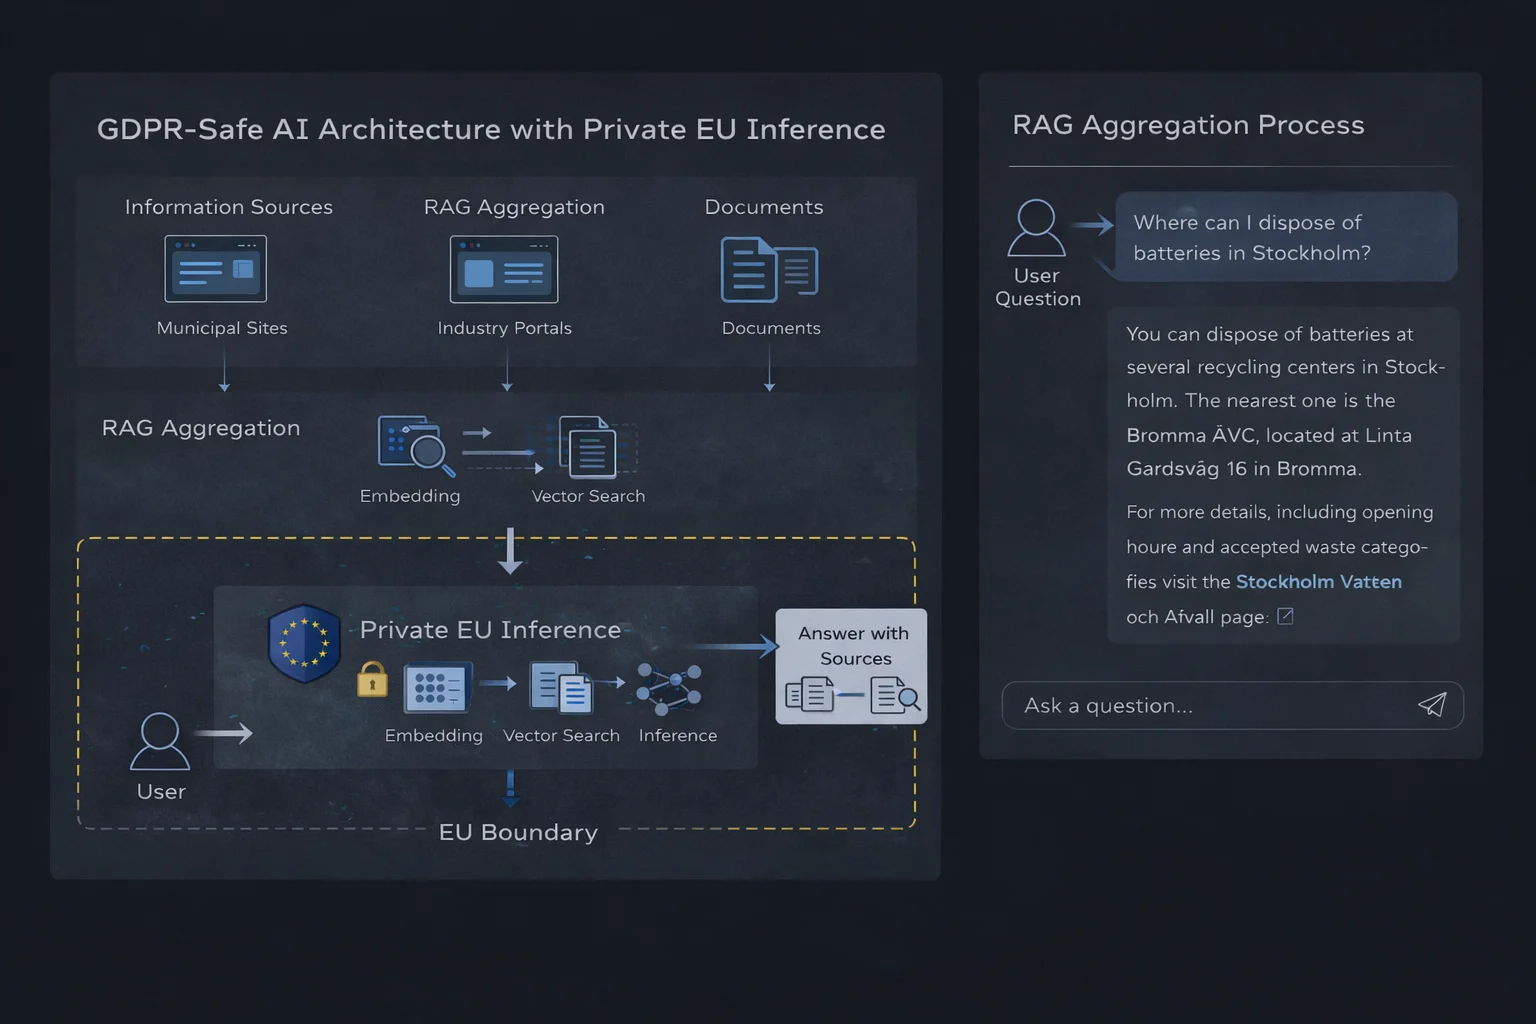 Privat EU-baseret AI-inferens-arkitektur med RAG-aggregering
Hvornår privat AI-inferens er det rigtige valg
Privat AI-inferens er ikke påkrævet for hver brugscase. Det bliver relevant, når applikationer skal operere inden for klare datagrænser, forudsigelig governance og eksplicitte compliance-begrænsninger.
Typiske scenarier inkluderer offentlige informationstjenester, interne vidensystemer, automatiseringspipelines og regulerede miljøer, hvor datalokalisering og behandlingskontrol ikke er til forhandling.
Juicefactory.ai tilbyder en privat inferens-runtime lokaliseret i EU, specielt designet til disse scenarier. Systemet gemmer ikke persondata og bruger ikke kundedata til modeltræning. Dens rolle er begrænset til kun inferens.
Teknisk arkitektur: retrieval-augmented generation
Retrieval-augmented generation kombinerer traditionel søgning med sprogmodelræsonnering. I stedet for at bede en model om at svare frit, henter systemet verificeret kontekst og begrænser svaret til den information.
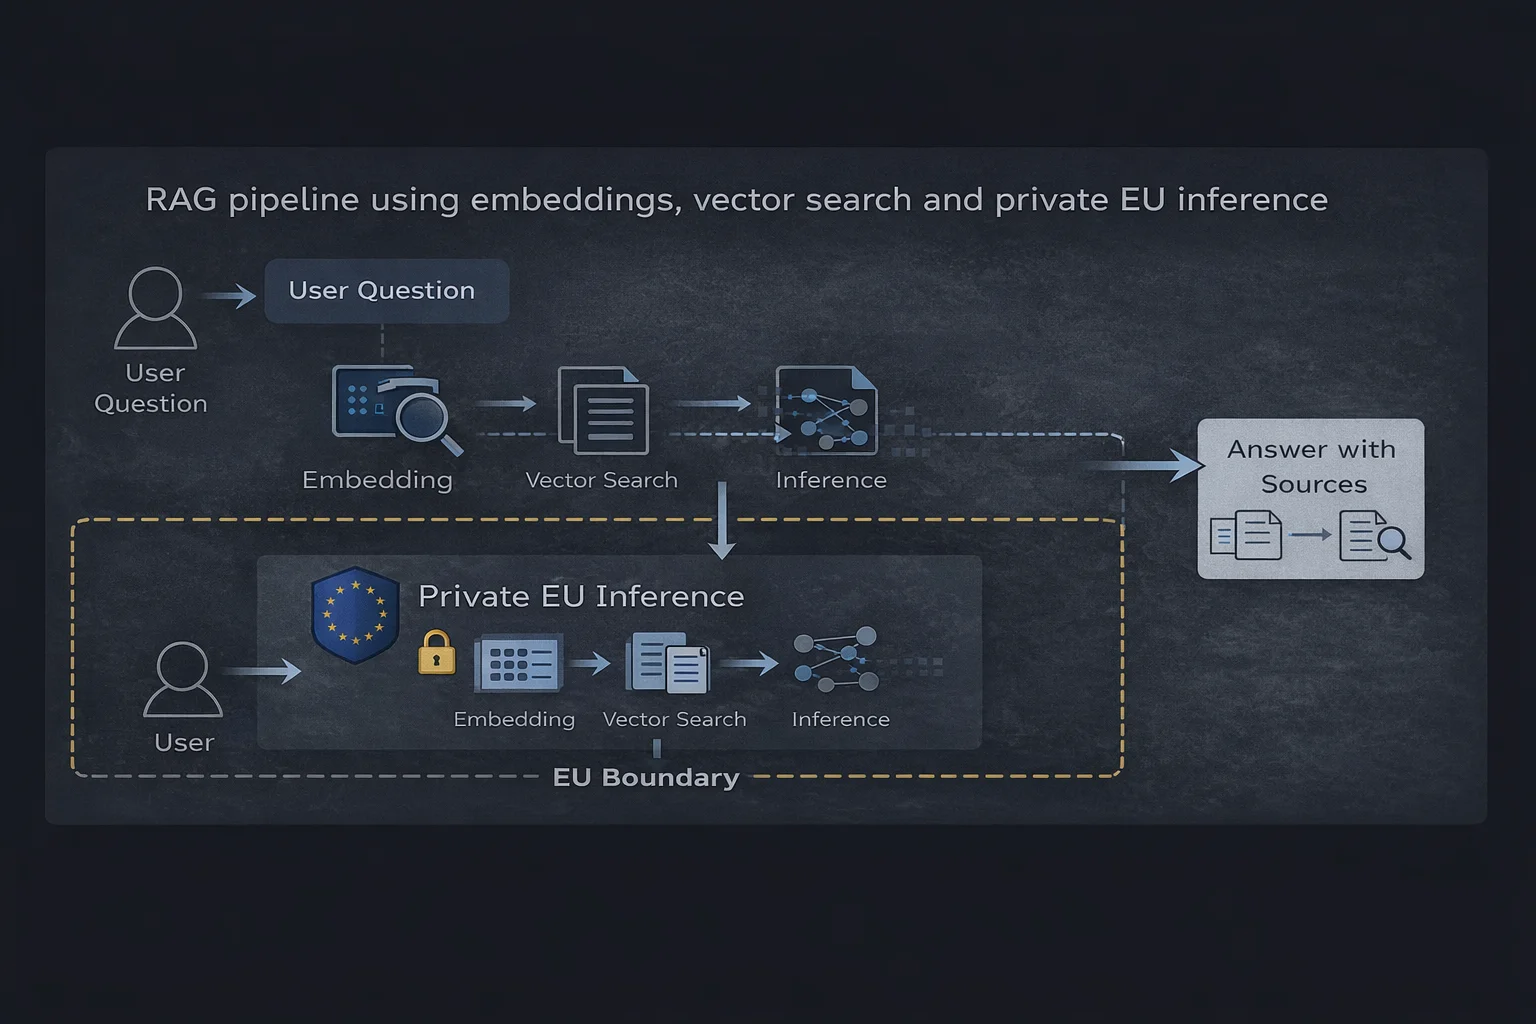 RAG-pipeline, der bruger embeddings, vektorsøgning og privat EU-inferens
Kernekomponenter
- En vektordatabase (som Qdrant), der gemmer indekseret indhold
- Embeddings brugt til at repræsentere dokumenter og spørgsmål
- Et hentningslag, der vælger relevant kontekst
- En privat inferens-runtime, der genererer begrundede svar
Flowet er simpelt: et brugerspørgsmål indlejres, relevant information hentes og modellen producerer et svar baseret kun på den kontekst.
Praktisk eksempel: forenkle adgang til offentlig information
Offentlig information er ofte fordelt på tværs af mange autoritative kilder. Kommunale hjemmesider, brancheportaler og officielle dokumenter kan alle indeholde korrekt information, men stadig være svære for brugere at navigere.
Et praktisk eksempel på denne tilgang kan ses i et virkeligt eksperiment, der udforsker, hvordan AI kan forenkle adgang til nationalt fragmenteret information uden at erstatte lokal autoritet.
Systemet henter relevant indhold, genererer en forklaring og peger brugere mod den korrekte autoritative kilde — reducerer friktion samtidig med at tillid bevares.
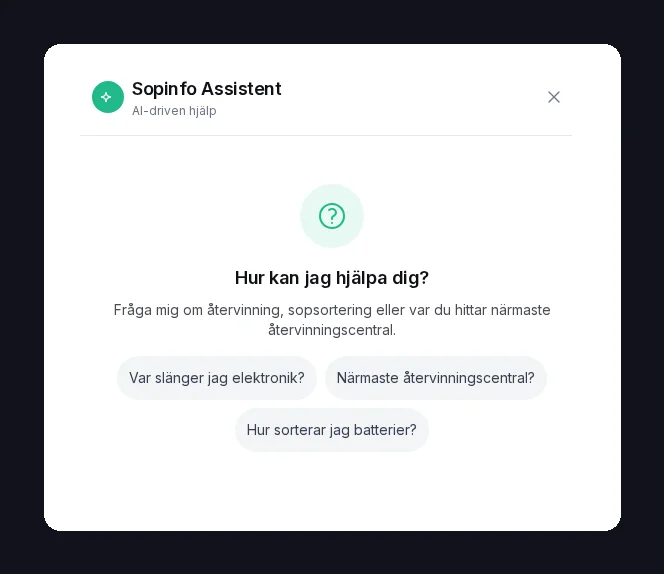 Eksempel på en live offentlig-informationsassistent, der bruger retrieval-augmented generation og privat EU-baseret inferens.
Hvorfor inferens-lokation betyder noget for GDPR
Selv når underliggende indhold er offentligt, fortolker inferensprocessen brugerintention og kontekstuelle forespørgsler. Denne behandling kan falde ind under GDPR-overvejelser, hvilket gør inferens-lokation og datahåndteringspraksis kritisk.
At køre inferens inden for EU giver klarere regulatoriske grænser, forudsigelig governance og større gennemsigtighed for både operatører og brugere.
Opsummering
Privat EU-baseret AI-inferens gør det muligt at kombinere moderne AI-evner med ansvarlig datahåndtering. Ved at parre retrieval-augmented generation med en kontrolleret inferens-runtime kan teams bygge nyttige, compliant systemer uden at ofre brugervenlighed eller kontrol.
Udforsk, hvordan erstatning af eksterne inferens-udbydere med EU-baseret infrastruktur fungerer i praksis, eller lær, hvordan automatiseringsworkflows integrerer med privat AI for ende-til-ende compliance.