Miten rakentaa GDPR-yhteensopivia tekoälysovelluksia käyttäen EU:ssa sijaitsevaa yksityistä päättelyä
Johdanto: Tekoälyn käyttöönotto kohtaa säännösten todellisuuden
Tekoäly on siirtynyt kokeiluista tuotantojärjestelmiin. Hakuavustajat, automaatiotyönkulut ja päätöksentuen työkalut ovat nyt osa päivittäistä toimintaa.
Euroopassa toimiville tai eurooppalaisia käyttäjiä palveleville tiimeille yksi rajoite tulee väistämättömäksi: missä tekoälypäättely tapahtuu, on yhtä tärkeää kuin mitä malli pystyy tekemään.
Vaikka taustalla oleva data olisi julkista, käyttäjäkyselyt, aikomukset ja vuorovaikutusmallit vaativat huolellista käsittelyä. Tämä opas selittää, miten EU:ssa sijaitsevaa yksityistä tekoälypäättelyä voidaan käyttää vaatimustenmukaisten, käytännöllisten tekoälysovellusten rakentamiseen hyödyntäen hakupohjaista generointia (RAG).
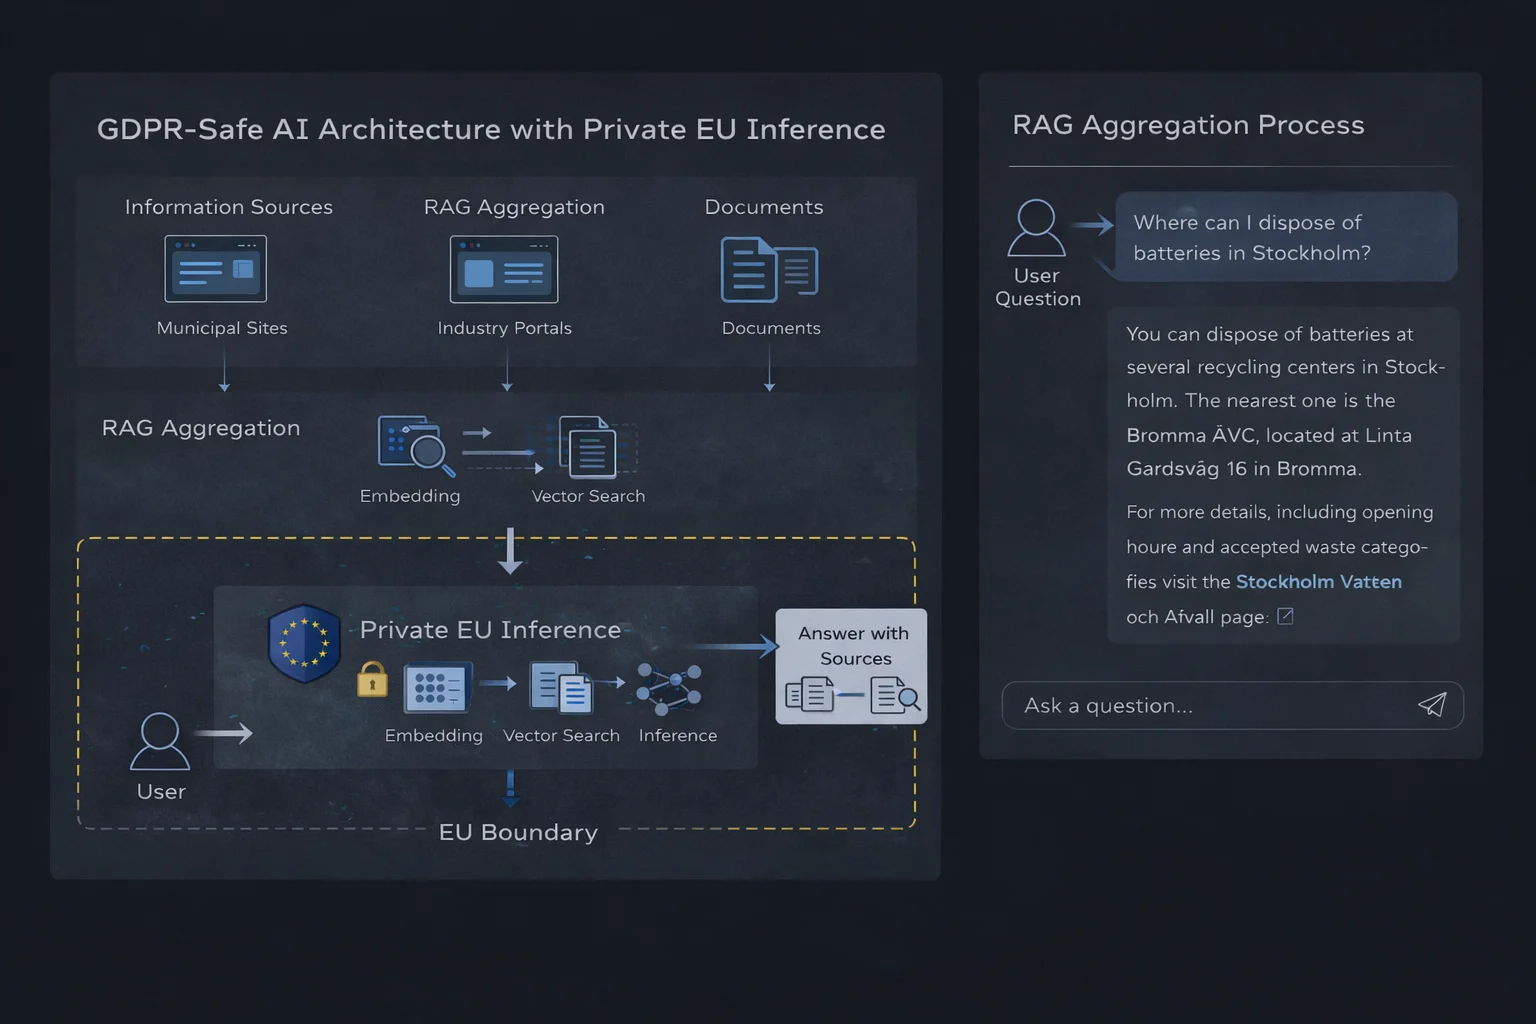 EU:ssa sijaitseva yksityinen tekoälypäättely-arkkitehtuuri RAG-aggregoinnilla
Milloin yksityinen tekoälypäättely on oikea valinta
Yksityinen tekoälypäättely ei ole pakollinen jokaisessa käyttötapauksessa. Siitä tulee relevantti, kun sovellusten on toimittava selkeiden datarajojen, ennakoitavan hallinnon ja selkeiden vaatimustenmukaisuusrajoitusten puitteissa.
Tyypillisiä skenaarioita ovat julkiset tietopalvelut, sisäiset tietojärjestelmät, automaatioputket ja säännellyt ympäristöt, joissa datan sijaintipaikan ja prosessointihallinnan vaatimukset eivät ole neuvoteltavissa.
Juicefactory.ai tarjoaa EU:ssa sijaitsevan yksityisen päättely-ajoympäristön, joka on suunniteltu erityisesti näitä skenaarioita varten. Järjestelmä ei tallenna henkilötietoja eikä käytä asiakastietoja mallin koulutukseen. Sen rooli rajoittuu pelkästään päättelyyn.
Tekninen arkkitehtuuri: hakupohjainen generointi
Hakupohjainen generointi yhdistää perinteisen haun kielimallin päättelyyn. Sen sijaan että mallilta kysyttäisiin vapaasti, järjestelmä hakee varmennetun kontekstin ja rajoittaa vastauksen siihen tietoon.
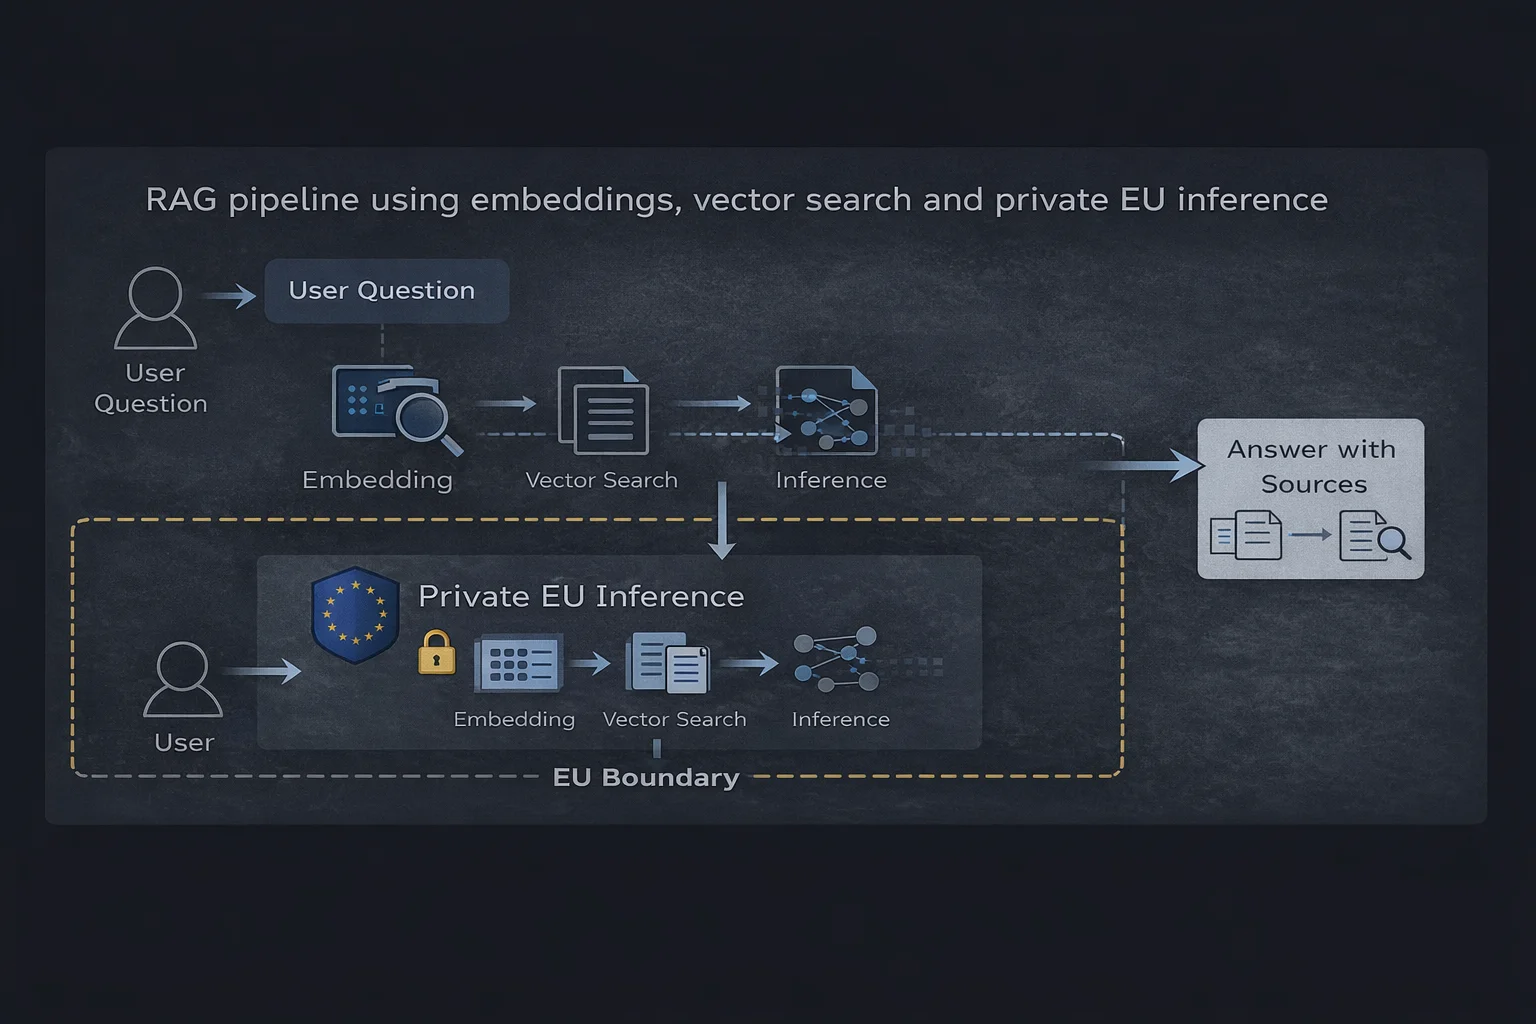 RAG-putki, joka käyttää upotuksia, vektorihakua ja EU:ssa sijaitsevaa yksityistä päättelyä
Ydinkomponentit
- Vektoritietokanta (kuten Qdrant), joka tallentaa indeksoitua sisältöä
- Upotukset, joita käytetään dokumenttien ja kysymysten esittämiseen
- Hakukerros, joka valitsee relevantin kontekstin
- Yksityinen päättely-ajoympäristö, joka generoi perusteltuja vastauksia
Kulku on yksinkertainen: käyttäjän kysymys upotetaan, relevantti tieto haetaan ja malli tuottaa vastauksen pelkästään sen kontekstin perusteella.
Käytännön esimerkki: julkisen tiedon saatavuuden yksinkertaistaminen
Julkinen tieto on usein hajallaan monissa auktoritatiivisissa lähteissä. Kuntien verkkosivustot, toimialaportaalit ja viralliset dokumentit voivat kaikki sisältää oikeaa tietoa, mutta silti olla vaikeita käyttäjien navigoida.
Käytännön esimerkki tästä lähestymistavasta nähdään tosielämän kokeilussa, joka tutkii, miten tekoäly voi yksinkertaistaa pääsyä kansallisesti hajallaan olevaan tietoon korvaamatta paikallista auktoriteettia.
Järjestelmä hakee relevantin sisällön, generoi selityksen ja ohjaa käyttäjät oikeaan auktoritatiiviseen lähteeseen — vähentäen kitkaa samalla säilyttäen luottamuksen.
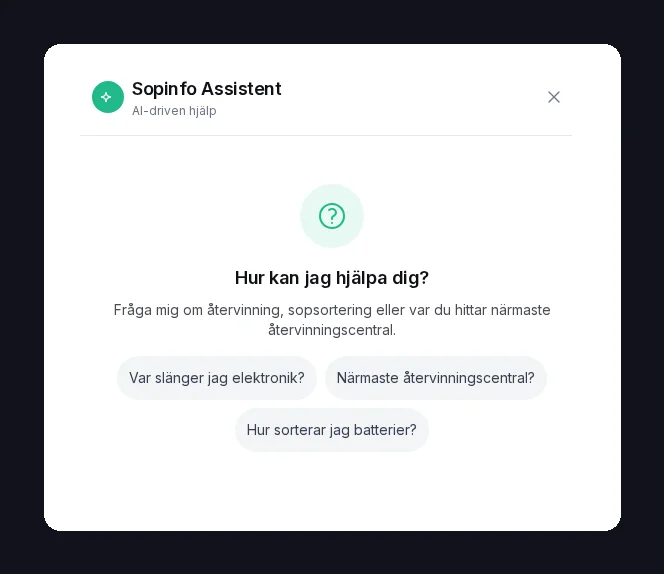 Esimerkki toimivasta julkisen tiedon avustajasta, joka käyttää hakupohjaista generointia ja EU:ssa sijaitsevaa yksityistä päättelyä.
Miksi päättelyn sijainti on tärkeä GDPR:n kannalta
Vaikka taustalla oleva sisältö olisi julkista, päättelyprosessi tulkitsee käyttäjän aikomuksen ja kontekstuaaliset kyselyt. Tämä prosessointi voi kuulua GDPR-huomioiden piiriin, mikä tekee päättelyn sijainnista ja datankäsittelykäytännöistä kriittisiä.
Päättelyn suorittaminen EU:ssa tarjoaa selkeämmät sääntelyrajat, ennakoitavan hallinnon ja suuremman läpinäkyvyyden sekä operaattoreille että käyttäjille.
Yhteenveto
EU:ssa sijaitseva yksityinen tekoälypäättely mahdollistaa modernien tekoälyominaisuuksien yhdistämisen vastuulliseen datankäsittelyyn. Yhdistämällä hakupohjaisen generoinnin kontrolloituun päättely-ajoympäristöön, tiimit voivat rakentaa hyödyllisiä, vaatimustenmukaisia järjestelmiä uhraamatta käytettävyyttä tai hallintaa.
Tutustu, miten ulkoisten päättelypalveluiden korvaaminen EU:ssa sijaitsevalla infrastruktuurilla toimii käytännössä, tai opi miten automaatiotyönkulut integroituvat yksityisen tekoälyn kanssa päästä päähän -vaatimustenmukaisuutta varten.